 EN
Quand un produit raconte sa propre histoire
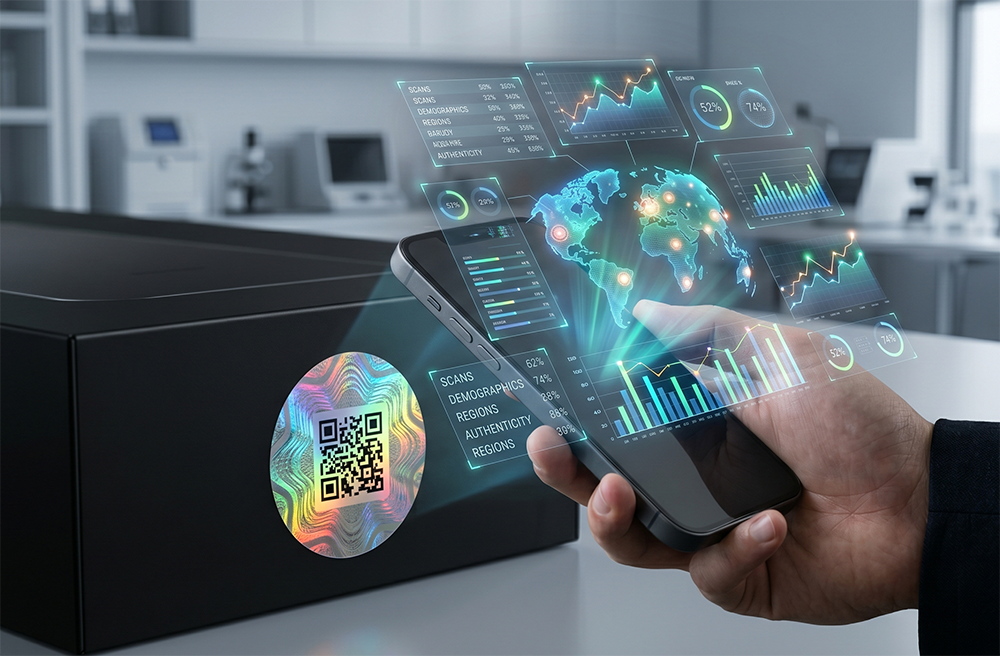
De nombreux responsables de marques considèrent encore le code QR comme un simple raccourci vers une page de destination. C’était vrai il y a dix ans. Ce qui a changé, c’est la couche de données située derrière cette numérisation. Chaque scan intègre désormais un horodatage, une empreinte géolocalisée, une signature d’appareil et un historique de session pouvant être croisé avec l’ensemble de l’historique de distribution du produit. Cette évolution transforme un simple motif imprimé en un réseau de capteurs actifs réparti sur chaque rayon, chaque entrepôt et la main de chaque consommateur.
Pourquoi deviner la visibilité de la chaîne d’approvisionnement coûte plus cher qu’il n’en rapporte
Le mode par défaut pour les marques grand public reste réactif. Un distributeur dans une région signale des ruptures de stock tandis qu’un autre détient trois mois d’inventaire sans que personne ne relie les éléments entre eux avant l’examen trimestriel. Le suivi par code QR modifie ce calcul, car les données arrivent en quelques heures, et non tous les trimestres. Une équipe marque peut identifier un déséquilibre régional des stocks pendant qu’il est encore temps de rediriger une expédition plutôt que de la solder ultérieurement. Ce type de réactivité ne concerne pas la technologie pour elle-même, mais la préservation de la marge qui s’érode silencieusement lorsque les décisions reposent sur des informations obsolètes.
L’anatomie d’un flux de données de suivi par code QR
Lorsqu’une étiquette portant un code QR sérialisé circule dans une chaîne logistique, chaque point de numérisation génère un événement structuré. Les champs de données minimaux viables ressemblent à ceci :
| Champ de données | Ce qu’il capture | Pourquoi cela compte |
|---|---|---|
| Timestamp | Instant exact UTC de la numérisation | Détecte le temps d’attente et les goulots d’étranglement |
| Coordonnées géographiques | Lieu de numérisation (entrepôt, magasin, consommateur) | Permet de localiser les détournements vers le marché gris |
| Type d'appareil | Pistolet de numérisation par rapport à un smartphone grand public | Distingue la logistique de l'engagement |
| Lot de produit | Lot de fabrication et code date | Permet des rappels ciblés |
| Statut d'authentification | Réussi / échoué / signalé | Bloque les contrefaçons en temps réel |
| Fréquence de balayage | Nombre de numérisations initiales par rapport au nombre de numérisations répétées | Identifie les schémas de revente ou de manipulation |
Cette granularité est ce qui distingue une approche moderne de traçabilité d’un simple comptage traditionnel de codes-barres. Un seul événement de numérisation est anecdotique ; un ensemble d’événements de numérisation sur trente jours dans douze provinces constitue une intelligence marché.
À quoi ressemble réellement la visibilité en temps réel sur le terrain
Une marque de cosmétiques de taille moyenne en Asie du Sud-Est a adopté des étiquettes QR sérialisées sur toute sa gamme haut de gamme de soins de la peau à la fin de 2024. La motivation initiale était simple : des revendeurs en ligne non autorisés undercotaient les partenaires de distribution agréés de 25 à 30 %, et la marque ne disposait d’aucun mécanisme permettant de retracer le distributeur responsable de ces fuites. Dans les six semaines suivant le déploiement, les données issues des scans effectués depuis les adresses de retour e-commerce et des scans de vérification par les consommateurs ont mis en évidence un regroupement d’unités toutes provenant d’un seul partenaire grossiste à Ho Chi Minh-Ville. La marque a rompu cette relation commerciale, redirigé le volume vers un distributeur conforme et récupéré environ 180 000 $ de marge annuelle sur le canal de distribution. Il ne s’agit pas d’un scénario hypothétique, mais bien de ce qui se produit lorsque les données de localisation sont combinées à la sérialisation à grande échelle.
Comment les données d’engagement des consommateurs bouclent la boucle de rétroaction
Il existe un deuxième avantage que les marques découvrent souvent par hasard. Lorsqu’un client scanne un code QR pour vérifier l’authenticité d’un produit, la marque reçoit un signal clair : cette personne détient effectivement le produit, à un lieu précis, et s’est suffisamment intéressée au produit pour en vérifier l’authenticité. Cela vaut bien plus que mille impressions de ciblage dynamique. Au fil du temps, les données géographiques et de fréquence des scans révèlent quels marchés affichent la demande organique la plus forte, quels partenaires de distribution génèrent le plus de trafic de vérification et quelles séries de produits enregistrent les taux de rescans les plus élevés — un indicateur utile de l’intention de réachat. Selon l’enquête mondiale GS1 2025 sur la numérisation de la chaîne d’approvisionnement, 64 % des propriétaires de marques ayant mis en œuvre une identification sérialisée des produits ont signalé une amélioration mesurable de la précision des prévisions de demande dans les douze mois suivants.
Mettre en place l’infrastructure adéquate sans la surcharger
La pile technique n’a pas besoin d’être écrasante. Au minimum, une marque a besoin de trois composants : des étiquettes QR numérotées avec impression sécurisée de données variables, une base de données cloud des événements de numérisation dotée d’une API propre, et une interface de vérification destinée aux consommateurs, généralement une page web mobile ou un mini-programme léger. Les étiquettes doivent résister aux conditions liées au cycle de vie du produit — l’humidité pour les boissons, l’abrasion pour les cartons logistiques — ce qui n’est certes pas trivial, mais tout cela est résoluble grâce à la bonne science des matériaux. Ce qui fait échouer la plupart des déploiements, ce n’est pas l’étiquette physique, mais la logique d’intégration entre la base de données de numérisation et le système ERP existant. L’achat d’un lot de 50 000 étiquettes relève d’un exercice d’approvisionnement ; faire en sorte que ces 50 000 événements de numérisation communiquent avec un ancien système de gestion des commandes relève, quant à lui, d’un exercice d’ingénierie des données.
OPOC apporte une profondeur pratique à ce domaine, avec des capacités internes de fabrication d’étiquettes et de sérialisation qui éliminent le problème courant de répartition des responsabilités que rencontrent souvent les marques lorsqu’elles font appel à un fournisseur pour les étiquettes et à un autre pour les logiciels. Le fait de disposer à la fois de l’étiquette physique et de l’infrastructure numérique sous un même toit réduit les renvois de responsabilité qui retardent généralement les délais de déploiement.
Table des matières
- Quand un produit raconte sa propre histoire
- Pourquoi deviner la visibilité de la chaîne d’approvisionnement coûte plus cher qu’il n’en rapporte
- L’anatomie d’un flux de données de suivi par code QR
- À quoi ressemble réellement la visibilité en temps réel sur le terrain
- Comment les données d’engagement des consommateurs bouclent la boucle de rétroaction
- Mettre en place l’infrastructure adéquate sans la surcharger