 EN

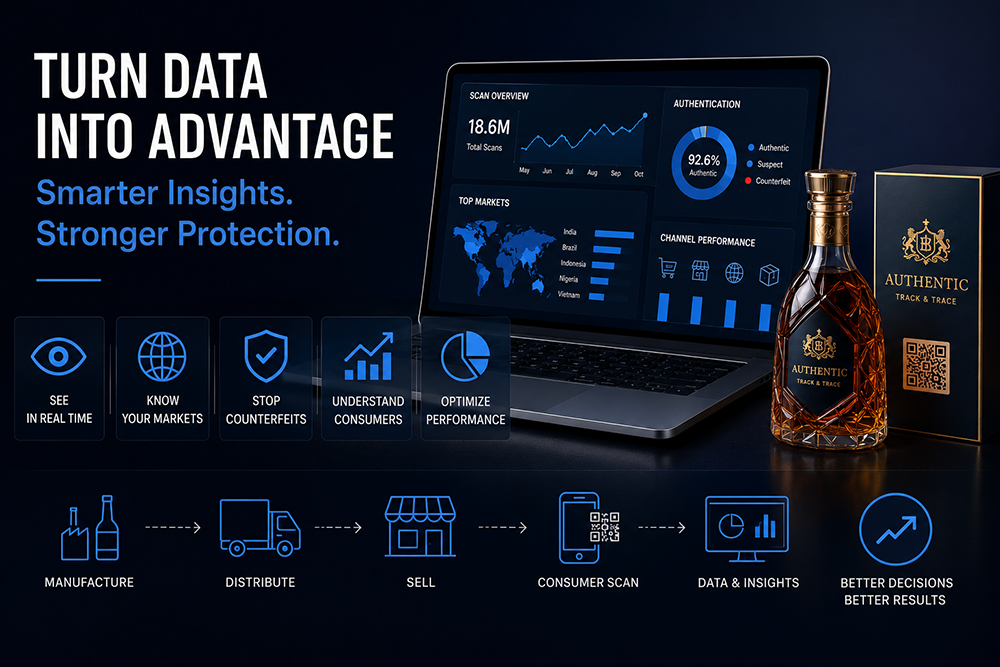
Sporing og sporingsfunktion er ikke et logistikværktøj – det er en datamotor
Udtrykket «sporingssystem» fremkalder for mange stadig billeder af lagerscannere og palleetiketter. Denne opfattelse er cirka fem år forældet. Et moderne sporingssystem genererer en kontinuerlig datatung fra hver knude i forsyningskæden: produktion, lagring, overdragelse til distributører, udstilling i detailhandlen og verificering af slutbrugeren. Spørgsmålet er ikke, om dataene findes, men om analytiklaget kan omdanne rå skanningslogfiler til beslutninger, der påvirker prissætning, distributionsstrategi, produktionsplanlægning og gennemførelse af mærkebeskyttelse. Et dashboard, der viser et grønt flueben ved siden af «sendt leveret», er det mindste, man forventer. Det, der adskiller en strategisk implementering fra en simpel efterlevelseskontrol, er, om systemet kan besvare spørgsmål, som mærkeholdet endnu ikke har tænkt på at stille.
Forskellen mellem at gemme skannehændelser og at forstå dem
Alle spor-og-spore-systemer registrerer som standard scanhændelser. En stregkode læses ved fabrikken, en anden scan ved distributionscenterets modtagekaj, og endnu en ved detailhandlens salgssted. At gemme disse registreringer er den nemme del. Analyseudfordringen ligger i mønstergenkendelse over tid og geografi. Et system, der ikke kan skelne mellem en legitim genopfyldningsscan og en unormal scanserie fra et tredje vagt på lageret efterfulgt af en stigning i e-handelsrabattilbud, er blot en digital arkivskab. Kapacitetsmanglen viser sig inden for tre områder: anomalidetektion, der markerer statistisk usandsynlige scansekvenser; geografisk clustering, der identificerer uautoriserede distributionshotspots; og tidsmæssig analyse, der afslører opholdstidsmønstre, der indikerer mulige vinduer for indførelse af forfalskede varer i logistikkæden.
Fem analysefunktioner, der adskiller grundlæggende systemer fra strategiske systemer
Når mærkeindehavere vurderer spor-og-spor-platforme, er funktionslisten ofte lang og fyldt med fagjargon. Når man reducerer den til det, der faktisk betyder noget for beslutningstagningen, er der fem analyseevner, der bør prioriteres:
| Analyseevne | Grundlæggende system (overholdelsesfokuseret) | Strategisk system (beslutningsfokuseret) |
|---|---|---|
| Visualisering af scanhændelser | Statisk kort med markører | Varmekort med tidsrulle og fremhævelse af anomalier |
| Opdagelse af gråmarkeder | Manuel rapportgenerering | Automatiserede geografiske anomalialarmer med tilskrivning på distributionsniveau |
| Analyse af forbrugerengagement | Antal scanninger pr. måned | Korrelation mellem scanning og køb, gen-scanningstakt pr. varenummer (SKU), kortlægning af brugerens rejse |
| Modellering af tilbagekaldsreaktion | Søgning efter parti-nummer | Realtime-geolokalisering af påvirkede enheder med estimering af notifikationsradius |
| Prædiktiv genfordeling af lagerbeholdning | Historiske salgsgennemsnit | Maskinlæringsbaserede efterspørgselssignaler fra serienummererede scanningshastigheder på tværs af regioner |
Systemerne, der leverer den højre kolonne, deler én arkitektonisk egenskab: De behandler hver scanning som en række i en tidsræksedatabase, ikke som et dokument i en flad log. Denne forskel er afgørende, når analysemotoren skal udføre aggregeringer på millioner af begivenheder på under tre sekunder for at fremhæve en advarsel.
Når data fra supply chain støder sammen med data om forbrugeradfærd
Der er et krydspunkt, som modne implementeringer konsekvent når omkring det attenmåneders tidspunkt. På det tidspunkt har systemet samlet tilstrækkeligt mange forbrugerbekræftelsesscanninger – det vil sige scanninger udført af slutbrugere via en brands godkendelsesportal – til at korrelere distributionsmønstre med faktisk køgeadfærd. En brand kan f.eks. opdage, at en distributør, der konsekvent rapporterer stærk salg gennem kanalen, faktisk har den laveste forbrugerscanningsrate i netværket, hvilket tyder på, at de rapporterede mængder ikke går til slutforbrugere. Eller branden kan finde ud af, at en bestemt detailkæde genererer bekræftelsesscanninger med tre gange den hastighed af sammenlignelige forretninger – et signal, der er værd at undersøge nærmere med henblik på udvidelse af partnerskaber. Disse indsigt er ikke tilgængelige alene fra salgsdata (sell-in-data). De kræver integration af serienummererede supply chain-scanninger med godkendte forbrugerinteraktionsdata – og netop her viser et forenet track-and-trace-system sin værdi ud over overholdelse af regler.
En farmaceutisk serialiseringsimplementering, der ændrede samtalen
En farmaceutisk producent fra Sydøstasien implementerede en serialiseret track-and-trace-løsning på sine produkter til selvkøb for at opfylde de opdaterede reguleringskrav fra ASEAN. Det oprindelige mål var efterlevelse: Hver enhed skulle have en unik identifikator, der kunne spores fra fabrikken til apoteket. Cirka ni måneder efter implementeringen bemærkede analyseafdelingen et usædvanligt mønster: Scan-hændelser for et populært smertestillende produkt koncentrerede sig i en provins, hvor virksomheden ikke havde nogen autoriseret grossistpartner. Yderligere analyse afslørede, at en licenseret distributor i en naboprovins omlejrede cirka 12 procent af sin tildelte mængde til ikke-registrerede apoteker på tværs af grænsen. Producenten genstrukturerede sine distributionsaftaler i den pågældende region, indførte geografisk begrænset scan-verificering på grossistniveau og reducerede udslippet til uautoriserede kanaler med en estimeret 60 procent inden for de følgende to kvartaler. Kravet om efterlevelse finansierede systemet; analyseevnen omdannede det til et værktøj til beskyttelse af overskuddet.
Hvordan analysedatabasen skal se ud fremadrettet
De næste tolv til fireogtyve måneder vil drive sporing- og sporingsanalyser mod tre konvergerende tendenser. For det første vil integrationen af serialiserede produktdata med detailhandlens kasseapparater lukke cirklen mellem afsendelse og forbrug og muliggøre næsten realtidsindsigt i salg til slutbruger, hvilket i dag kræver manuel afstemning. For det andet vil maskinlæringsmodeller, der er trænet på historiske scanningsmønstre, begynde at fremhæve prædiktive risikovurderinger for specifikke distributionskanaler og markere potentiel afledning, inden den sker, i stedet for efterfølgende. For det tredje udvider reguleringsrammerne på markeder såsom EU, i henhold til direktivet om forfalskede lægemidler, og i flere sydøstasiatiske lande kravene om serialisering ud over lægemidler til kosmetik, kosttilskud og forbrugsvarer med høj værdi. Mærker, der opbygger denne analytiske kapacitet nu, vil være foran compliance-kurven i stedet for at skulle skynde sig for at indhente tabt tid.
OPOC producerer serienummererede spor-og-sporetiketter med integreret variabel data direkte i produktionsprocessen, hvilket giver mærkeindehavere et enkelt kildepunkt til at opbygge deres analyseinfrastruktur uden at skulle samle flere etiket- og softwareleverandører sammen.
Indholdsfortegnelse
- Sporing og sporingsfunktion er ikke et logistikværktøj – det er en datamotor
- Forskellen mellem at gemme skannehændelser og at forstå dem
- Fem analysefunktioner, der adskiller grundlæggende systemer fra strategiske systemer
- Når data fra supply chain støder sammen med data om forbrugeradfærd
- En farmaceutisk serialiseringsimplementering, der ændrede samtalen
- Hvordan analysedatabasen skal se ud fremadrettet